Rehber · · 4 dk okuma · Webitro ekibi
Veri kazıma nedir? Web scraping nasıl çalışır, nerede durmak gerekir
Veri kazıma nedir, web scraping API ne işe yarar? Bir kazıyıcının nasıl çalıştığını, yapay zekânın katkısını ve hukuki sınırları sade bir dille anlatıyoruz.
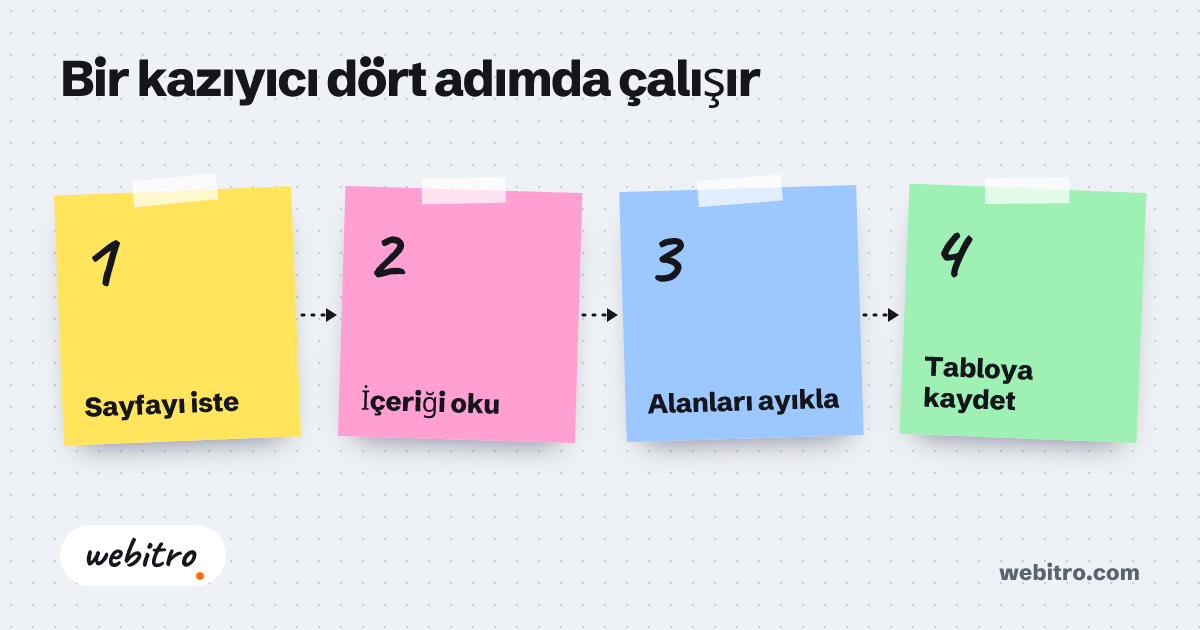
Bir kazıyıcı dört adımda çalışır
- 1Sayfayı iste
- 2İçeriği oku
- 3Alanları ayıkla
- 4Tabloya kaydet
“Veri kazıma nedir?” sorusunun kısa cevabı şu: bir programın internet sayfalarını sizin yerinize okuyup içindeki bilgiyi tabloya dökmesidir. Yirmi ürünün fiyatını elle kopyalayabilirsiniz. Yirmi bin ürün için bir programa ihtiyacınız olur. Bu yazıda kazımanın nasıl çalıştığını, nerelerde kullanıldığını ve hangi noktada durmanız gerektiğini anlatıyoruz.
Web kazıma nedir, web scraping nedir?
İkisi aynı şeyin iki adıdır. “Web scraping nedir?” diye soran da “web kazıma nedir?” diye soran da aynı tekniği kasteder: web sayfalarından otomatik veri toplamak. Türkçede kazıma, İngilizcede scraping denir.
Veri kazıma biraz daha geniş bir terimdir. Web sayfalarının yanında PDF dosyalarını, tabloları ve başka belgeleri de kapsar. Gündelik kullanımda üçü birbirinin yerine geçer.
Sık karıştırılan bir kavram daha var: tarama (crawling). Tarayıcı program sayfadan sayfaya bağlantıları izler ve hangi sayfaların var olduğunu çıkarır. Kazıyıcı ise belli sayfalardan belli alanları alır. Çoğu projede ikisi birlikte çalışır.
Bir kazıyıcı nasıl çalışır, nerede zorlanır?
Tarayıcınız bir adrese gittiğinde sunucudan bir HTML belgesi alır ve onu ekranda sayfa olarak gösterir. Kazıyıcı aynı belgeyi alır ama göstermez, içinden istediği parçaları seçer.
Sıra hep aynıdır. Program sayfanın adresine istek gönderir ve HTML’i alır. İçinde aradığı alanı bulur, çünkü ürün adının hangi etiketin içinde durduğunu önceden bilir. Alanı temizler, örneğin fiyatı sayıya çevirir. Kaydı tabloya yazar ve sıradaki sayfaya geçer.
Kâğıt üzerinde bu kadar basittir. Uygulamada üç yerde zorlanır.
Bazı siteler içeriği sayfa açıldıktan sonra JavaScript ile yükler. İlk gelen HTML neredeyse boştur. Bu durumda kazıyıcının gerçek bir tarayıcıyı arka planda çalıştırması gerekir. Bu yöntem daha yavaştır ve daha çok kaynak tüketir.
Siteler tasarım değiştirir. Ürün adının durduğu etiket değişince kazıyıcı boş değer getirmeye başlar. Düzenli çalışan her kazıyıcı bakım ister.
Bir de hız meselesi var. Bir siteye saniyede yüzlerce istek gönderen program o siteyi yavaşlatabilir ve engellenir. İyi yazılmış bir kazıyıcı istekleri aralıklı gönderir.
Nerelerde kullanılır?
Ortak nokta şudur: bilgi zaten herkesin görebileceği yerdedir ama dağınıktır. Elle toplamak günler alır ve ertesi gün eskir.
- Fiyat takibi: bir mağazanın rakip fiyatlarını her gün görmesi.
- Pazar araştırması: bir sektördeki ürünlerin, ilanların ya da firmaların listesini çıkarmak.
- İçerik izleme: ihale, mevzuat ya da duyuru sayfalarındaki yenilikleri yakalamak.
- Akademik çalışma: araştırma için erişime açık metinleri derlemek.
- Arama motorları: web’in dizinini çıkarmak da özünde bir tarama ve kazıma işidir.
Web scraping API ne işe yarar?
Kazıma işinin en zahmetli kısmı sayfayı güvenilir biçimde indirmektir. Web scraping API adı verilen servisler bu kısmı üstlenir. Siz servise bir adres gönderirsiniz, servis sayfayı indirir, gerekirse JavaScript’i çalıştırır ve sonucu size döndürür.
Kendi altyapınızı kurmak istemiyorsanız ya da kaynak siteler arka planda tarayıcı çalıştırmayı gerektiriyorsa bu servisler zaman kazandırır.
Bu servis alanları sizin yerinize düşünmez. Hangi bilginin gerekli olduğuna, verinin nasıl temizleneceğine ve nereye yazılacağına yine siz karar verirsiniz. Bazı sitelerin kendi resmî API’si de vardır. Varsa önce ona bakın. Resmî API’den gelen veri düzenlidir ve kullanım şartları bellidir.
Yapay zekâ bu işte neyi değiştirdi?
Eskiden her site için ayrı kural yazılırdı. Dil modelleri sayfayı okuyup “bu ürün adı, bu fiyat” diyebiliyor. Daha önce görmediği bir sayfa düzeninde de çalışabiliyor. Dağınık metni sınıflandırmakta ve farklı yazılmış aynı bilgiyi eşleştirmekte de iyi.
Bedeli var. Her sayfayı modele okutmak, kuralla ayıklamaktan daha yavaş ve daha pahalıdır. Model sayfada olmayan bir değeri uydurabilir. Bu yüzden yaygın yöntem ikisini birleştirmektir: kesin alanlar kuralla, yorum isteyen alanlar modelle ayıklanır ve sonuç örneklerle denetlenir.
Bir örnek verelim. Yüz farklı tedarikçi sitesinden ürün bilgisi toplayacaksanız yüz ayrı kural yazmak uzun sürer, sayfayı modele okutmak daha hızlı sonuç verir. Tek bir siteden her gün çok sayıda sayfa alacaksanız kural yazmak daha doğrudur.
Hukuki ve etik sınırlar
Sitelerin kök dizininde çoğu zaman robots.txt adlı bir dosya bulunur. Site sahibi bu dosyayla otomatik programların hangi sayfalara girmesini istemediğini bildirir. Protokolün standardı bu kuralların bir erişim yetkilendirmesi olmadığını açıkça söyler. Yani teknik bir kilit işlevi görmez. Yine de bu kurallara uymak iyi niyetin ilk göstergesidir.
İkinci belge sitenin kullanım koşullarıdır. Bazı siteler otomatik toplamayı açıkça yasaklar. Şifreyle korunan alana girmek ya da güvenlik önlemini aşmak ise bambaşka bir konudur ve yapılmamalıdır.
Üçüncüsü kişisel veridir. Ad, telefon, kişiye ait e-posta gibi bilgiler herkese açık bir sayfada dursa bile KVKK ve GDPR kapsamındadır. Bu tür veriyi toplamadan önce amacınızı ve hukuki dayanağınızı netleştirin. Emin değilseniz bir hukukçuya sorun.
Kazıma basit bir fikirdir ama düzenli çalışan bir sistem hâline getirmek emek ister. Küçük ve tek seferlik bir iş için hazır araçlar yeter. Verinin her gün temiz ve eksiksiz gelmesi gerekiyorsa Webitro bunu size özel yazılım olarak kurar.
Hizmetler: Veri kazıma yazılımı ve size özel web scraping API’si
Veri Kazıma
Örnek senaryo
Sık sorulan sorular
Veri kazıma yasal mı?
Tek bir cevabı yoktur. Erişime açık ve kişisel olmayan veriyi sitenin koşullarına uyarak toplamak daha düşük risklidir. Kullanım koşullarını çiğnemek, korumalı alana girmek ya da kişisel veriyi dayanaksız işlemek hukuki risk doğurur.
Web scraping için kod bilmek gerekir mi?
Basit işler için gerekmez. Tarayıcı eklentileri ve kodsuz araçlar birkaç sayfadan tablo çıkarabilir. Çok sayıda kaynak, düzenli çalışma ve veri temizliği gerekiyorsa kod yazmak gerekir.
Web scraping API ile sitenin resmî API’si aynı şey mi?
Hayır. Resmî API’yi sitenin kendisi sunar ve veriyi düzenli biçimde verir. Öteki ise üçüncü bir servistir, sayfayı sizin adınıza indirir. Resmî API varsa önce onu tercih edin.
Kazıyıcı neden bir süre sonra çalışmaz olur?
Çoğunlukla kaynak site tasarımını değiştirdiği için. Kazıyıcı aradığı alanı eski yerinde bulamaz ve boş değer getirir. Düzenli kontrol ve bakım bu yüzden gerekir.
Yapay zekâ kazıyıcının yerini alır mı?
Hayır. İkisi birlikte kullanılır. Sayfayı indirmek ve kesin alanları ayıklamak hâlâ klasik yöntemlerle daha hızlı ve ucuzdur. Yapay zekâ dağınık metni anlamlandırmada ve sınıflandırmada öne çıkar.